
过去几周,我给朋友、同事、还有一只非常配合的狗,渲染了几十条 Burning Bridges 视频。如果你还没刷到过这个梗:它出自 Drake《Burning Bridges》MV 里的水晶吊灯派对——满屋宾客、手里一只银色调酒器,还有那个标志性的"Where she at?"动作:一只手横在眼前扫视全场。现在大家都在用 AI 把自己、朋友、甚至宠物塞进这个场景里,成品是真的好笑。
这篇文章不是工具大全,而是我现在真正在用的流程、照片上的几个关键取舍,以及我踩过的四个坑——有两个我当时还以为是平台出 bug 了。如果你正准备做第一条,看完能省下不少废掉的渲染额度。
这个梗到底是什么(30 秒版)
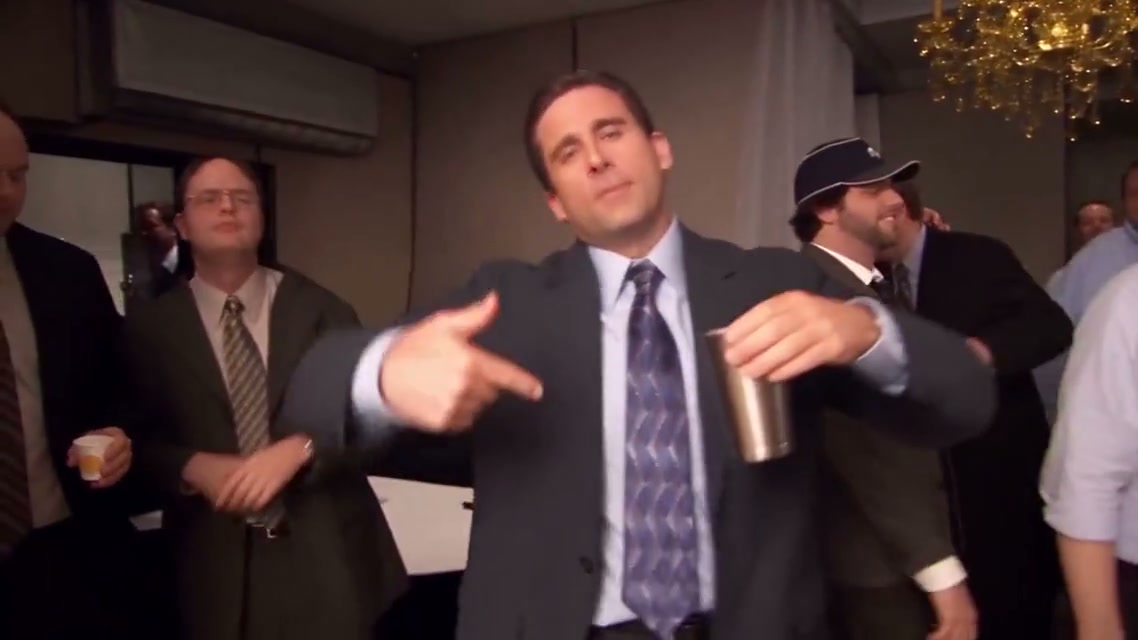
《Burning Bridges》是 Drake 2026 年专辑《Iceman》里的歌。所有人复刻的是官方 MV 里的这一段:主角从吊灯下的人群里走出来,举着银色调酒器指向镜头,理了理衣领,给宾客倒酒,然后——也就是变成 meme 的那个瞬间——一只手横在眼前扫视房间,像在找什么人。这个手势在 2026 年世界杯期间彻底火了:Drake 在球场大屏上做了这个动作,C罗紧接着也来了一遍。
这个梗适合 AI 复刻的原因很简单:它是一镜到底的手持镜头,动作清单短而固定,正好是"参考视频迁移"类模型最擅长的事。你的照片决定视频里是谁,模板负责房间、人群、调酒器和整套动作。
我们自己模板复刻的就是下面这个场景——满屋宾客、水晶吊灯、举杯的人群:
照片决定了 90% 的效果
这是我用同一个人的三张不同照片渲染同一条视频得出的结论。三条成片不只是质量有差异——有两条看起来像两个不同的人。
实测有效的做法:
- 正脸、清晰、光线正常。 听起来像废话,但一张稍微有点糊的派对自拍,渲染出来主角的脸到一半就开始漂移;一张干净的手机人像,全程身份稳定。
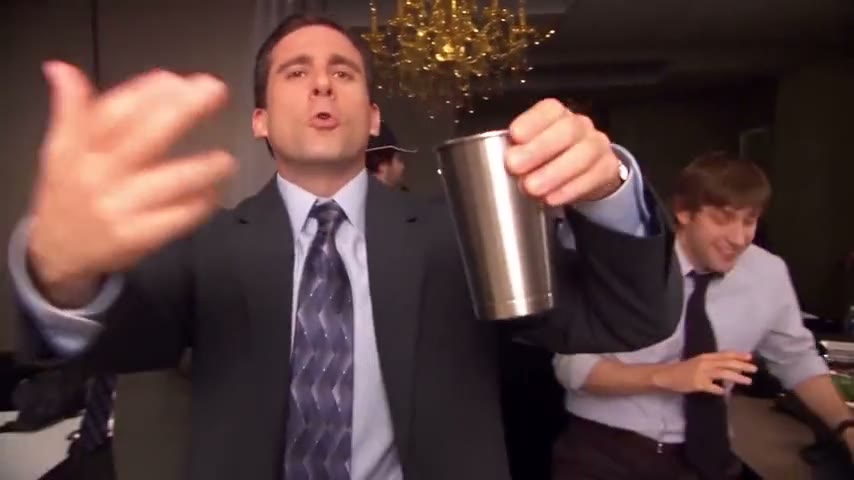
- 把你想保留的穿搭拍进去。 成片会保留照片里的衣服——眼镜和帽子也是。有位朋友发来一张只露脸的特写,模型给他脑补了一件外套。想让"理衣领"那个动作成立,照片里最好有衣领。
- 半身或全身。 只露脸的裁切会丢掉躯干,模型猜不到手臂位置,调酒器的动作就会变得很怪。
- 一张照片一个人。 我试过把两个人塞进一张合影里做双人版,结果模型把两人的五官融合了。分开拍,分开传。
说得具体一点,能当参考照片的就是下面这种画面——主体正脸清晰、握调酒器的手可见、周围留够了派对场景,模型才知道往哪儿放人:
大家最常问的:宠物行不行?行。那条狗的成片里它直立站在派对中间,爪子里握着调酒器,卡点做遮眼动作。荒诞,但非常好笑。
动手前先提醒一句:别拿名人照片试。后面踩坑部分会讲为什么——这是花了我最长时间才定位的问题。
我现在的流程(三步,大概五分钟)
我用的是我们自己的 Burning Bridges AI 模板,难免有偏心,但所有像样的模板工具流程都长一个样——真正的差别在出错的时候怎么处理:
- 上传主角照片。 这个人就是视频里的表演者——脸、发型、穿搭,照片里能看到的一切都会进成片。
- 可选:再加一张照片。 双人版支持第二位主角。空着的位子会由模板自带的群演补上,背景路人用默认的就挺好。
- 生成、预览、下载。 渲染几分钟出片。我会检查脸有没有漂、调酒器有没有换手,没问题就下载。成品也会存进我的生成记录——这个功能救过我两次,都是提前关了页面的时候。
这个阶段不需要写提示词,场景和编舞模板都带好了。我试过绕开模板、把长提示词直接贴给裸的视频模型,得到的是一段平庸的派对跳舞,遮眼动作直接被跳过——打包模板存在的意义,就是有人已经替你把这些坑调试完了。
这就是我每次起步用的模板预览——看一遍你就知道模型要复刻的是哪些动作:
模型怎么挑(附实测观察)
这是别人基本不写、但对成片影响很大的部分。同一个模板、同一张照片,三个模型家族——三种明显不同的效果,三种完全不同的翻车方式。
| 模型 | 时长 / 画质 | 参考素材 | 我的评价 |
|---|---|---|---|
| MiniMax H3 | 4–15 秒 · 768P/2K | 参考视频 + 照片 | 现在的默认选择。出片最快、观感最好,什么素材都吃得下。 |
| Seedance 2.0 | 4–15 秒 · 720p | 参考视频 + 照片 | 编舞迁移最忠实。有一次渲染被音频版权拦了——后面细说。 |
| Gemini Omni Flash | 3–10 秒 · 360p–4K | 仅照片 | 1080p 以上人脸保真度最高,但拒绝一切视频参考,对人脸政策也最严。 |
三条烧了真金白银才换来的经验:
- Google 系模型会拒绝名人脸,而且报错不会告诉你原因。 我拿一张影视剧照试过,任务直接失败,报错是一句干巴巴的 "invalid argument",看着像平台 bug。我把同一张图重新编码、清干净元数据再传——照样失败。换成普通人的照片,第一次就过了。这是内容政策,不是故障:这类模型会拒绝可识别的公众人物,提示词怎么改都没用。
- 参考视频的影响没有照片大。 走照片驱动这条路时,模板的参考片段只负责编舞和运镜。我效果最好的几条,全是"好照片 + 默认参数",而不是反复调动作设置调出来的。
- 参考素材必须公网可达。 我在模板外面裸调 API 测试时,一个需要登录才能访问的参考 URL 直接报下载错误,根本走不到生成那一步。在模板里这一步是自动处理的——上传会落到平台自己的存储上。
如果你只是想要那条视频:默认模型、一张好照片、点生成。新用户可以在这里买积分——失败的渲染会自动退款,试错花的是时间,不是钱。
我踩过的四个坑(和解决办法)
就算你一个都碰不上,也值得看一遍——其中两个我当时真的以为是平台出 bug 了。
- 照片明明没问题,报 "invalid argument"。 就是上面说的名人脸拒绝。我的第一反应是文件格式有问题,甚至把 JPEG 从头重建了一遍、清掉了所有元数据——照样失败。换成一张普通朋友的照片:一次过。所以如果你的渲染报了个含糊的 400 类错误,先看看参考图里是谁的脸,别急着怪工具。
- 被"音频版权"拦截。 有一次 Seedance 渲染失败,提示生成音频命中受限内容。原因:参考片段带着原曲音轨,被版权过滤器抓住了。解决办法:要么用帮你处理音频授权的模板,要么先把参考片段的音轨剥掉、发 TikTok/Reels 的时候再在站内加原曲——反正后面也该这么做(见下一节)。
- 调酒器中途换手。 动作迁移的经典毛病。我裸写提示词的实验里,杯子在视频过半时从左手跳到了右手。明确写明哪只手("holds the silver shaker in their LEFT hand")就修好了。模板内置了这条;自己裸写提示词的话,一定要写。
- "Where she at?" 遮住了整张脸。 标志性动作是手挡在眼睛上——我最初的几版连嘴一起挡了,最出彩那行的对口型直接废掉。提示词里写"hand over the eyes, mouth visible"就对了。模板默认就是对的,又一条裸写提示词才需要操心的。
出片之后我怎么发
- 竖屏赢。 9:16 在 TikTok、Reels、Shorts 上都是满屏。我发过的每一条横版,数据都不如同一条渲染的竖版。
- 在 App 里加官方原声。 渲染成片自带的是通用音轨。发布后从平台曲库里加"Burning Bridges"原声效果最好——还能挂上趋势页,那才是流量的入口。两条声音都有的时候,把成片自己的音轨压低。
- 授权这件事别省。 我只渲染本人同意出镜的人,测试里被用脸的那位朋友对成片有一票否决权。梗是好玩的梗,但谁也不想自己的脸出现在没答应过的地方。
- 速度比精修重要。 我观察过的每个趋势模板,热度周期就一两周。趁声音还在上升期发一条不错的成片,好过等它过了峰值再发一条完美的。我数据最好的那条是第二次尝试的版本,不是第五次。
写于 2026 年 10 月 10 日,基于我在 ViralReel Burning Bridges 模板上的真实渲染。趋势背景(专辑发行、世界杯名场面)来自公开报道——如果要正式引用,建议再核对一遍。